「404 Not Found」と表示されたときの、意味・原因・解決方法を整理します。ブラウザー側で試せる対処から、Apacheのアクセスログで404が出ているURLを特定して、サーバー運用側から直す方法まで、公式ドキュメントで確認できる内容を踏まえて紹介します。
 管理人
本記事の読者層は以下の方を想定しています。
- ブログを運営していて、404エラーへの対処方法を知りたい人
- インターネットを閲覧中に404 Not Foundに遭遇し、原因と、元のページの内容を見る方法を知りたい人
- サーバー運営者で、404の原因をアクセスログから調べたい人
404 not found とは ?(404エラーとは?)
ネットを閲覧していると、クリックした先のURLで、「Not Found. The requested URL was not found on this server.」と表示されることがあります。
これは、「サーバー上に、要求されたファイルやページが存在しないこと」を示すエラーです。
404 Not Found(ページが見つからないエラー)の要点
- 意味
①指定されたWebページが存在しない(削除された、またはURLが間違っている)場合に、サーバーが返すエラーメッセージ (HTTPステータスコード404) - 訪問者(読者)ができること
①打ち間違いや余計な文字が入っていないか確認すること
②キャッシュのクリア、古い一時データを消して再読み込みしてみること
③サイト内の検索窓から探すか、「Webアーカイブ(過去の保存ページ)」で過去の情報を調べること - サイト運営者ができること
①アクセスログ等で、どのURLで404が発生しているか把握すること
②転送設定(301リダイレクト)を使い、新しいURLへ自動的に誘導すること
③無理にトップページ等へ飛ばさず404のままにし、元の場所や別ページへ案内する「オリジナルの404ページ」を設置すること

この表示が出たときのエラーは、通称「404エラー」と呼ばれています。
「404」という数字は、HTTPのステータスコード(HTTP response status codes)の1つです。サーバーは、リクエストへの応答にこの番号を付けて返すため、番号を見れば、エラーの種類を特定できます。
HTTPステータスコードとは?
ステータスコードは、最初の桁によって5つのクラスに分類されます。最初の桁が応答のクラスを定義し、最後の2桁には、分類のための役割はありません。404は、このうち4xx(クライアントのエラー応答)に含まれます。
以下に、標準で定義されている5つのクラスのステータスコード一覧を示します。
ステータスコード一覧 : HTTP response status codes
| # | コード | 名称 | 説明 |
|---|---|---|---|
| 1xx | 100-199 | 情報応答 | リクエストが継続中であることをクライアントに通知 |
| 2xx | 200-299 | 成功応答 | 成功した応答が受信され、解釈が修正され、受け入れを通知 |
| 3xx | 300-399 | リダイレクトメッセージ | リクエスト完了前にアクションを実行する必要があることを通知 |
| 4xx | 400-499 | クライアントのエラー応答 | リクエスト構文に問題がありリクエストを完了できないことを通知 |
| 5xx | 500-599 | サーバエラー応答 | 有効なリクエストだがサーバーの問題により完了できないことを通知 |
閲覧者として知っておきたいコードとして、
同じ400番台には、アクセス権がないことを示す「403 Forbidden」もよく知られています。
その他の詳細なステータスコードの番号と意味は、MDN Web DocsのHTTPステータスコード一覧(英語)をご覧ください。
404 エラーは本当に修正すべき?
「ホームページを作ったり運営したりしているあなた」が知っておきたい、404エラーとの付き合い方について解説します。
Googleは、「存在しないページが『ページが見つかりません(404)』という状態になること自体は、検索順位に悪い影響を与えない」と説明しています。そのため、ネット上のすべての404エラーを無理になくす必要はありません。
しかし、読者(サイトの訪問者)が実際にアクセスしてしまい、そのページが「404エラー」になってしまう場合は、以下の理由から修正する価値があります。
読者が迷子になる404ページを直すべき3つの理由
①サイトの使いやすさがアップする:サイトナビゲーションの改善
サイト内のリンク切れで404が表示されると、読者は目的のページにたどり着けず、ユーザーエクスペリエンスが低下します。リンク先を直すと、サイト内を移動しやすくなり、読者が次のページへ進みやすくなります。
②せっかくの訪問者を逃さなくない:トラフィックの回収
ページのURLを変更したときに、古いURL(404記事)のままにしておくと、そこからやってきた訪問者が行き場を失ってしまいます。新しいページへ自動的に案内する設定(転送設定)をしておくと、訪問者を逃さずキャッチできます。
③古い情報の整理ができる:古いコンテンツの更新
404エラーが出ているURLを調べると、「すでに消したはずの記事へのリンクがあちこちに残っている」といった問題に気づけます。必要に応じて、リンクや記事を最新の状態に整えましょう。
注意:修正のつもりが逆効果になる設定
エラーを直そうとして、「存在しないページを、すべてトップページへ強制的に飛ばす」という設定をするのはNGです。
Googleは、こうした設定を「本当はないのにエラーを返さない紛らわしい状態(soft 404)」と呼んでいます。読者も検索エンジンも混乱してしまうため、避けるようにしましょう。
Googleは、存在しないページに404や410以外のコードを返すことや、404の代わりにトップページなどへ転送することを「soft 404」と呼び、ユーザーにも検索エンジンに
具体的な正しい設定方法は、次の章で説明します。
まずは、なぜ404エラーが起きてしまうのか、その原因から整理していきましょう。
404 エラーの原因はどこにあるのか? (404 error)
404エラー(ページが見つからないエラー)が発生する主な原因としては、以下のような理由が挙げられます。
404 エラーが起こる5つの原因。
エラーには、以下の理由が考えられます。
404エラーが起こる主な原因
- ファイルの削除や移動
内部リンクの調整をしないまま、ページ、ファイル、画像などを削除/移動した場合。 - URLの入力ミス
閲覧者がブラウザのアドレスバーに誤ったURLを入力した場合。 - サーバーの停止・切断
URL先のサーバーが稼働していなかったり、接続が切断されていたりする場合 - ドメイン名のトラブル
入力されたドメインがIPアドレスに変換できない場合
またはドメイン自体が存在しない場合
サーバーエラーに関する補足
上記のうち、最後の2つ(サーバーの停止やドメインのトラブル)は、サーバー自体が正常に応答を返せない状況です。ステータスコードは本来サーバーが返す番号であるため、この場合は厳密には「404(Not Found)」ではなく、接続エラーなどの別のエラー表示になることが一般的です。
それでも、閲覧者にとっては「目的のページが見られない」という結果は同じであるため、広い意味での原因候補としてここに含めています。
いずれの原因であっても、404エラーが発生すると、せっかくリンクをたどってきてくれた訪問者を見失うことになり、サイトの機会損失につながってしまいます。
次に、原因ごとの対処方法を説明します。
404 エラーの6つの原因と対処方法
404エラーが発生する原因は、大きく分けて「ブラウザ側(閲覧者が自分で試せるもの)」と「サーバー側(サイトの管理者しか直せないもの)」の6つに分類されます。
番号の「①から順に」確認していくことで、スムーズに原因を特定できます。
404 エラーの原因一覧
【ブラウザ側】
- ①ブラウザ上に古いキャッシュが残っている可能性
- ②URLの入力ミスや古いリンクを踏んでいる可能性
【サーバー側】
- ③サーバー自体に障害やメンテナンス中の問題がある可能性
- ④URLの転送(リダイレクト)設定に失敗している可能性
- ⑤そもそもファイルやURLが存在しない(削除・移動された)可能性
- ⑥ファイルの文字コードに問題がある(ファイルはあるのに表示されない)可能性
ブラウザ側(閲覧者)の原因と対処方法
閲覧者自身ですぐに試せるため、解決の難易度は低めです。
①ブラウザ上にキャッシュが残っている可能性
ブラウザが過去のページ情報(キャッシュ)を保持しているため、すでに存在しない古いURLへアクセスしてしまい、404エラーになることがあります。
- 解決方法:お使いのブラウザ(Google Chrome、Safari、Microsoft Edge、Firefoxなど)の設定から「キャッシュのクリア」を行い、ページを再読み込みしてください。
②URLが間違っている可能性
URLの入力ミス(ヒューマンエラー)や、古いリンクのまま移転前のURLにアクセスしている可能性があります。
- 解決方法:検索エンジン(Google等)でキーワードを再検索し、正しい最新のリンク先を探してみましょう。
コラム:エラーになったページの元の内容を見たい場合
「404 Not Found」と表示されてしまっても、工夫次第で目的の情報や過去の内容にたどり着けることがあります。以下の方法を上から順に試してみてください。
1. サイト内の検索機能を使う
URLが変更されただけで、ページ自体は別のURLに残っている可能性があります。そのサイトの検索窓にキーワードを入れて、現在のページを探します。
2. Wayback Machine(インターネット・アーカイブ)で探す
ページがすでに削除されている場合でも、Internet ArchiveのWayback Machineを使うと、過去に保存されたページのコピーを閲覧できることがあります。404になったURLをそのまま入力して検索してみましょう(※すべてのページが保存されているわけではありません)。
(※サイト管理者で、削除したファイルの手元にバックアップがある場合は、後述の⑤の方法でアップロードし直せばページを復旧できます)
サイトの管理者で、削除したファイルが手元にある場合は、⑤の方法でアップロードし直すと、ページを復旧できます。
サーバー側(管理者)の原因と対処方法
ここからは、Webサイトの運営者・管理者でないと解決できない原因です。
③サーバーの運営そのものに問題がある可能性
サーバーがメンテナンス中であるか、何らかの理由で一時的にネットワークが停止している可能性があります。この場合、厳密には404ではなく「503 Service Unavailable」などの別のエラーコードが返ることが一般的です。
- 解決方法:しばらく時間を置いてから、再度アクセスしてつながるか確認してください。
④URLの転送(リダイレクト)に失敗している可能性
ページを移転した際のリダイレクト設定に不備があるケースです。
- 解決方法:サーバー内の
.htaccessファイルや、Webサーバーの設定ファイルに記述した転送設定を確認・修正します。
⑤ファイル/URLが存在しない可能性
そもそもファイルが「存在しない」、もしくは「リンク切れ」している可能性があります。また、何らかの理由により、サーバー側でファイル(ページ)が削除、移動された可能性もあります。
- 解決方法:管理者であれば、FTPサーバーなどでファイルをアップロードし直しましょう。
⑥ファイル名のコードに問題がある可能性(ファイルはあるのに404になる場合)
サーバー上にファイルが存在しているにもかかわらず404エラーが出る場合は、ファイル名やファイル内の文字コードが原因となっていることがあります。例えば、ファイルをアップロードした際に、標準の「UTF-8」から別の文字コードに意図せず変換されてしまうケースが挙げられます。
- 解決方法:該当ファイルの文字コードを確認し、必要に応じて修正します。Linux環境では、主に以下のコマンドを使って確認できます。(※以下のコマンドは「ファイルの中身(テキスト)」の文字コードを判定するものであり、ファイル名自体の文字コードを調べるものではありません)
fileコマンドで確認する
サーバー内で、次のfileコマンドを用いて、ファイルの文字コードを確認します。
$ file -i ファイル名

(実行例)
$ file -i link_checker.py
link_checker.py: text/x-python; charset=utf-8nkfコマンドで確認する
nkfコマンドを用いても、文字コードを確認できます。
# (必要に応じてインストール)
$ sudo apt-get install nkf
# 文字コードの推測・確認
$ nkf -guess ファイル名
それでも原因が分からない場合
上記①〜⑥のポイントを確認しても原因が特定できない場合や、サイト内のどこで404が頻発しているか分からない場合は、サーバーのアクセスログを解析して実態を調べる必要があります。
次の章では、アクセスログを使った具体的な原因究明の方法を解説します。
サーバーのアクセスログから404 エラーの原因を究明
サーバーのアクセスログから原因を究明する
ここでは、Webサーバーの運営者・管理者向けに、アクセスログを使って404エラーの原因を調べる方法を解説します(※今回は、Apache 2でWebサーバーを運用している場合を想定しています)。
1. アクセスログ(access.log)で実態を調べる
サーバーの access.log ファイルを参照し、ステータスコード「404」が出ている行を探します。アクセス元のURL(リファラー)が記録されていれば、「どのページのリンクが切れているのか」まで突き止めることができます。
2. Google Search Consoleとの違い・使い分け
Googleが提供する「Google Search Console」を使っている場合、「ページ」レポートの「見つかりませんでした(404)」からも、Googleが検出したエラーURLを確認できます。
ただし、Search Consoleで分かるのは「Googleがクロール(巡回)したURL」に限られます。サーバーに届いたすべてのアクセス(ユーザーが実際に踏んだリンクなど)を網羅的に調べるには、やはりサーバーのアクセスログを確認するのが確実です。
Ubuntu環境における404 not found の見つけ出し方
Ubuntu環境では、標準で /var/log/apache2 ディレクトリにアクセスログが保存されています。
以下の表示例は「Ubuntu 26.04 LTS」をベースにしています。
ログファイルの構成
対象のフォルダに移動して ls コマンドを実行すると、以下のようにログファイルが保存されています。
$ ls
access.log        access.log.12.gz  access.log.3.gz  access.log.7.gz  error.log.1      error.log.13.gz  error.log.3.gz  error.log.7.gz
access.log.1      access.log.13.gz  access.log.4.gz  access.log.8.gz  error.log.10.gz  error.log.14.gz  error.log.4.gz  error.log.8.gz
access.log.10.gz  access.log.14.gz  access.log.5.gz  access.log.9.gz  error.log.11.gz  error.log.16.gz  error.log.5.gz  error.log.9.gz
access.log.11.gz access.log.2.gz access.log.6.gz error.log error.log.12.gz error.log.2.gz error.log.6.gz other_vhosts_access.log*.gz:アーカイブ化(GZIP形式)された過去のログファイルです。
access.log:数字のついていないものが「現在記録されている最新のログ」です。古いものほど後ろの番号が大きくなります。
アクセスログのフォーマット(記録形式)
access.log の1行を抜粋すると、以下のように記録されています
60.40.xxx.xxx - - [11/Sep/2022:00:10:35 +0900] "GET /blog/ HTTP/1.1" 200 16549 "-" "Mozilla/5.0 (Windows) mirall/2.11.1 (build 8438) (ownCloud, windows-10.0.22000 ClientArchitecture: x86_64 OsArchitecture: x86_64)"Apacheの設定ファイル(apache2.conf など)では、このログの形式(LogFormat)が以下のように定義されています。
【LogFormatの設定例】
LogFormat “%h %l %u %t \”%r\” %>s %b \”%{Referer}i\” \”%{User-Agent}i\””
【ログ項目の対応表】
| # | Format | 名称 | 説明 |
|---|---|---|---|
| 1 | %h | リモートホストのIPアドレス | 60.40.xxx.x |
| 2 | %l | 接続先のユーザー名 | -(未設定) |
| 3 | %u | リモートユーザー名 | -(未設定) |
| 4 | %t | アクセスされて日時 | [11/Sep/2022:00:10:35 +0900] |
| 5 | \”%r\” | アクセスされたファイル | GET /blog/ HTTP/1.1″ |
| 7 | %t | ステータスコード | 200 |
| 8 | %b | リソースに対する転送量 | 16549 |
| 9 | \”%{Referer}i\” | アクセス元のURL | -(未設定) |
| 10 | \”%{User-Agent}i\” | なんのOSでどのブラウザからアクセスしてきたか | Mozilla/5.0 (Windows) mirall/2.11.1 (build 8438) (ownCloud, windows-10.0.22000 ClientArchitectu re: x86_64 OsArchitecture: x86_64) |
この表の各項目とログの一行を見比べると、対応関係が分かります。ここで知りたいエラーコードの情報は、表の「ステータスコード」の欄です。404エラーが発生した場合、表の 「ステータスコード」の欄に「404」 が記録されます。
ログファイルの簡単な解析方法
パターンA:コマンドでステータスコード別の件数を集計する
以下のコマンドを実行すると、アクセスログに含まれるすべてのステータスコードを集計し、件数が多い順に並べることができます。
$ cat access.log | cut -d ' ' -f 9 | sort | uniq -c | sort -nrCatコマンドの引数指定
① -dで、行を区切る文字(区切り文字)を指定。
② -f で、区切った〇番目のフィールド(項目)を取り出す
【実行結果の例】
$ cat access.log | cut -d ' ' -f 9 | sort | uniq -c | sort -nr
   9026 200
   3704 302
    140 304
    108 301
     32 "-"
     27 206
     12 404
     10 400
      6 401
      2 201
このコマンドは、次の順に処理します。
cut -d ' ' -f 9:各行をスペースで区切り、9番目のフィールドを取り出します。上のログの一行では、この9番目がステータスコードです。日時([11/Sep/2022:00:10:35と+0900])と、アクセスされたファイル("GET/blog/HTTP/1.1")の中にスペースがあるため、前の表の番号とは一致しません。sort | uniq -c:取り出したステータスコードを並べ替え、同じ値の件数を数えます。sort -nr:件数の多い順に並べ替えます。
この出力結果から、今回のログには 404エラーが12件 発生していることが分かります。
パターンB:grepで404エラーの行だけを直接抽出する
404エラーの件数が少ない場合や、具体的なURLをサクッと確認したいときは、grep コマンドを使うのが手軽です。
$ cat access.log | grep '" 404'【出力例】
66.249.XX.XX - - [18/Sep/2022:09:05:48 +0900] "GET /blog/archives/date/2022/page/11 HTTP/1.1" 404 66101 "-" "Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) 66.249.XX.XX - - [18/Sep/2022:09:05:48 +0900] "GET /blog/archives/date/2022/page/11 HTTP/1.1" 404 66101 "-" "Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P)... (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"この出力結果を読み解くと、以下のことが分かります。
対象のURL:/blog/archives/date/2022/page/11 で404エラーが発生している。
アクセスの正体:User-Agentに Googlebot とあるため、Googleの検索ロボットがこのURLにアクセスして404を受け取った。
このようにログ解析を行うことで、どのページで404が発生しているかを正確に突き止めることができます。原因が分かったら、前章で紹介した「301リダイレクト」や「オリジナル404ページ」などの対策を適用しましょう。
404 エラーの解決方法
アクセスログなどで特定したエラーURLは、主に次の2つのパターンに分けて対処を検討しましょう。
404エラーへの対処の基本方針
- 移転・URL変更したページ:新しいURLへ「301リダイレクト(恒久的な転送)」を行う
- 本当に存在しないページ:無理に飛ばさず「404のまま」にし、専用のオリジナル404ページで案内する。
1. 移転したページは「301リダイレクト」で新しいURLへ案内する
ページを別のURLへ移動した場合は、サイトのルートディレクトリ(最上位フォルダ)にある .htaccess ファイルなどに設定を追加します。これにより、古いURLにアクセスした読者を自動的に新しいページへ案内できます。
Redirect permanent "/旧ページのパス" "https://www.domain.com/新ページのパス"ドメインの指定:「[https://www.domain.com/](https://www.domain.com/)」の部分をご自身のサイトのドメインに書き換えてください。
ステータスコードの重要性:Apacheの Redirect ディレクティブでは、ステータスを指定しないと一時的な転送(302)になってしまいます。恒久的にページを移転した場合は、必ず permanent(または 301)を明記しましょう。
2. 避けるべき設定(すべてのページをトップへ飛ばす仕組み)
よくある間違いとして、存在しないページへのアクセスをすべてトップページへ強制的に転送させる設定があります。
ErrorDocument 404 https://www.domain.com/ErrorDocument に上記のような外部URL(フルURL)を指定すると、Apacheは正しい「404」ではなく、転送を示すステータスコードをブラウザに返してしまいます。
前の章でも触れたとおり、Googleは「存在しないページなのに404を返さず、トップページ等へ転送する設定」をソフト404(Soft 404)として問題視しています。読者も検索エンジンも混乱させてしまうため、このような設定は避けるようにしましょう。
オリジナルの404 pageの作成
本削除されたページや存在しないURLにアクセスされた場合は、トップページへ無理に転送するのではなく、エラーコード「404」を返しながら自サイト専用の「オリジナル404ページ」を表示するのがベストな方法です。
「ページが存在しないこと」を正しく伝えつつ、訪問者が別のページへ移動できるような導線(トップページへのリンクや記事一覧など)を用意しましょう。
ワンポイントアドバイス(410エラーについて)
ページを完全に削除し、今後も復元する予定がないことを検索エンジンに明確に伝えたい場合は、404の代わりに「410 Gone(消滅しました)」というステータスコードを返す選択肢もあります。
オリジナル404ページの作成・設定方法
一般的なWebサイト(.htaccessが使える環境)の場合
オリジナルの404ページは、サーバー上の.htaccessファイルに以下の1行を追加します。
※ /404.html には、ご自身で作成したエラーページ用ファイルのパス(保存場所)を指定します。
ErrorDocument 404 /404.html※ 「http://」から始まるフルURLではなく、「/」から始まるサーバー内のパスで記述することで、正しい404エラーコードを維持したまま独自のページを表示できます。
WordPressの場合
お使いのWordPressテーマフォルダ内に404.phpというファイルを設置するだけで、自動的にオリジナル404ページとして認識されます。
オリジナル404ページに入れるべき3つの要素
- ページが存在しないことを明確に伝える
「お探しのページは見つかりませんでした」など、分かりやすい言葉で状況を伝えます。 - 次の行き先を用意する
トップページへのリンク、サイト内検索窓、人気記事一覧、サイトマップなどを設置し、離脱を防ぎます。 - サイト全体とデザインを統一する
普段のページと同じヘッダーやフッター、デザインを適用し、サイト内に留まっている安心感を与えます。
✨ 補足事例
企業によっては、遊び心のあるイラストやユニークなメッセージを取り入れ、エラーページ自体を1つのブランディングやPRとして活用しているケースもあります。
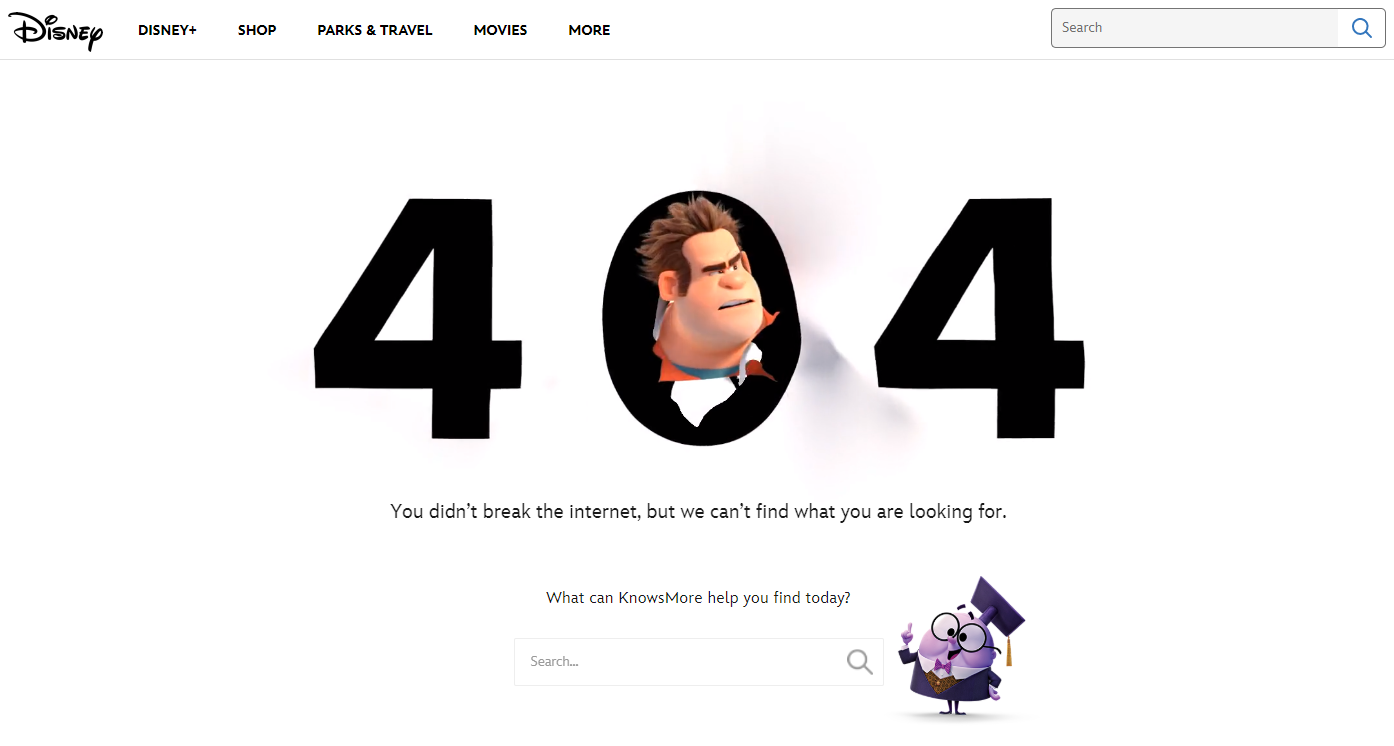
例1:下記のケースは米国Disneyの404エラーのページです。
こちらの画像は、WEBマーケティングメディア『Search Engine Journal』でも紹介された、米国Disney(ディズニー)のオリジナル404ページです。米国Disneyの公式サイト(disney.com)は、日本国内からアクセスすると自動的に日本版(disney.co.jp)へ転送(リダイレクト)されてしまいます。
米国Disneyのサイトは、こちらです。
例2:下記のケースは米国StarWarsの404のページです。

こちらの画像は、米国『Star Wars(スター・ウォーズ)』公式サイト(StarWars.com)のオリジナル404ページです。実際のページは、StarWars.comの404ページで確認できます(※作品世界にちなんだユニークな演出が用意されています)。
たった1つの404エラーページであっても、訪問者をがっかりさせず楽しませるような工夫には、WEBサイト運営において学べるポイントがたくさんありますね。
設定後に、ステータスコードを確認する
設定したら、ステータスコードが意図どおりかを確認します。curl -Iは、ページ本体ではなく、応答のヘッダー(ステータスコードを含む)だけを表示するコマンドです。
$ curl -I https://www.domain.com/存在しないパス表示の1行目に、ステータスコードが出ます。存在しないURLなら「404」、301リダイレクトを設定した旧URLなら「301」になっていれば、意図どおりです。
404 Not Foundのよくある質問 (FAQ)
Q. 404 Not Foundが自分だけに表示されるのはなぜですか?
A. 他の人には問題なく見えているのに、自分だけエラーになる場合は、以下の順に確認してみてください。
- ①別のブラウザや端末で試す→スマートフォンや別のパソコン、別のブラウザ(ChromeやSafariなど)でも同じようにエラーになるか確認します。
- ②URLに間違いがないか確認する→アドレスバーの入力ミスや、不要な文字が混ざっていないかチェックします。
- ③ブラウザのキャッシュをクリアする→古いデータが残っていることが原因の場合があるため、キャッシュを削除してページを再読み込みしてみます。
- ④それでも直らない場合は管理者に連絡する→自分だけアクセスできない原因が分からないときは、サイトの運営者・管理者に問い合わせてみましょう。
Q. 404 Not Found が急に落ちました。どうすればいいですか?
A. サイトの運営中に、急にエラーが出るようになった場合は、以下の順に原因を調べましょう。
- ①エラーの範囲を確認する→「特定のページだけ」で起きているのか、それとも「サイト全体のすべてのページ」で起きているのかを確認します。
※すべてのページで見られない場合はサーバー自体が停止している可能性が高く、404以外のエラーが表示されることが一般的です。 - ②直前の作業を振り返る→エラーが出る直前に、ファイルの削除・移動を行ったり、サーバーの設定ファイルを変更したりしていなかを確認します。
- ③アクセスログを確認する→サーバーのアクセスログをチェックし、エラーが出始めた正確な時間や、該当するURLを特定します
Q.404 エラーを解消するにはどうすればいいですか?
エラーを解決する方法は、「サイトを見ている人(閲覧者)」と「サイトを作った人(管理者)」の立場で異なります。
A. 閲覧者の場合
- ①URLをよく確認する
- ②ブラウザのキャッシュをクリアする
- ③サイト内の検索機能を使う、または過去の保存ページ(Webアーカイブ等)を探す
A. サイト管理者の場合
- ①アクセスログでエラーの起きているURLを特定する
- ②ページを移転・変更した場合は、新しいURLへ自動転送する設定(301リダイレクト)を行う
- ③完全に削除したページなどは無理に飛ばさず、適切な「オリジナルの404エラーページ」を表示して別のページへ案内する
まとめ
404 Not Foundについてのまとめです。
- 「404 Not Found」は、サーバーが要求されたページを見つけられないときに返されるHTTPステータスコード。
- 原因はブラウザー側とサーバー側に分けて確認でき、元の内容はサイト内検索やWayback Machineで探せる場合がある。サイト管理者は、アクセスログから、404が出ているURLを特定できる。
- 移転したページは新しいURLへ301リダイレクトし、本当に存在しないページは404のまま、オリジナルの404ページで案内する。トップページへの転送は避け、設定後はステータスコードを確認する。
次回の記事をご期待ください。どうぞよろしくお願いいたします。
関連リンク

コメント